从ChatGPT到AI Agent:人工智能将如何改变分析化学实验室?
当大语言模型(large language model, LLM)开始编写处理质谱数据的代码、提出逆合成路线并整理化学文献,分析化学实验室该以什么姿态接纳这些工具?基于2021至2026年间发表的59项研究,这篇发表于Analytica Chimica Acta的评述(Human-in-the-loop AI in analytical chemistry: a critical review from large language models to agentic systems)给出了立场:不押注完全自主的AI,而是把人在回路(human-in-the-loop)的代理系统作为未来十年的候选运行架构,化学家负责指挥与验证,AI负责执行。
评述在Scopus、Web of Science、PubMed与Google Scholar四个数据库检索2021年1月至2026年5月的文献,保留59项报告可量化性能或明确概念框架的研究,其中50项(85%)发表于2024至2026年。结果显示,微调后的LLM从期刊文献提取化学数据的准确率超过99%,零样本模式仅40%–70%;生成式模型已把药物化学的限速步骤从分子提案推向候选验证;评述据此把实验室AI整理为从单LLM副驾到自主机器人化学家的四级自主谱系,并把2026年多数分析化学实验室的务实入口定在第二级的工具增强单代理。该工作为分析化学实验室的技术选型、同行评议规则与研究生AI素养培养提供了依据。
AI在化学领域的应用正由单一模型走向工具协同。文章将大语言模型、生成式化学设计及具备工具调用能力的代理系统放在同一框架下讨论。
四级自主化框架用于理解不同系统的适用场景。从对话式副驾、工具增强型单代理,到多代理协作及自主机器人实验室,作者认为多数分析化学实验室现阶段更适合从工具增强型单代理入手。
AI可以加速质谱结构注释,但不能代替化学鉴定。指纹预测、计算机模拟碎裂与从头结构生成各有局限,候选结构仍需独立证据验证。
文章给出三项面向实验室的建议。结合本组数据和文献建立检索增强生成(RAG)工具、将AI辅助编程纳入日常方法开发,并完善AI使用的透明披露规则。
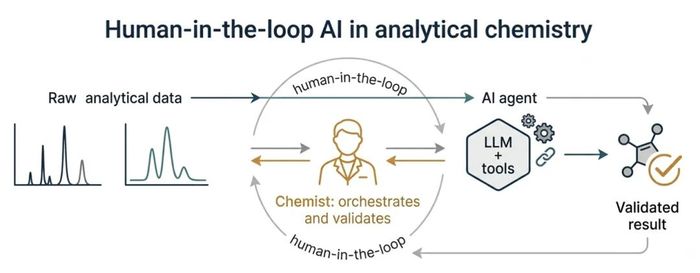
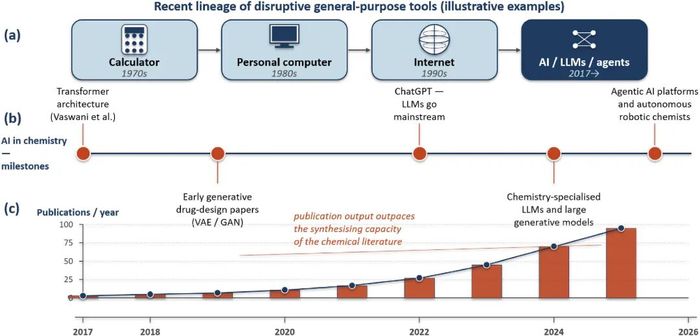
图1 AI是通用工具谱系的最新一环,2017至2026年三条技术流汇合,出版增速已超过个人读者的吸收能力
(a)给出计算器、个人计算机、互联网与AI及代理系统四代工具的谱系;(b)标出Transformer架构、ChatGPT让LLM走向主流等化学相关里程碑;(c)显示2017至2026年化学出版量逐年攀升。评述据此论证,AI带来的不是例外事件,而是计算器、个人计算机与互联网那类工具更替的延续,迟到的代价可能落在课题组竞争力层面。
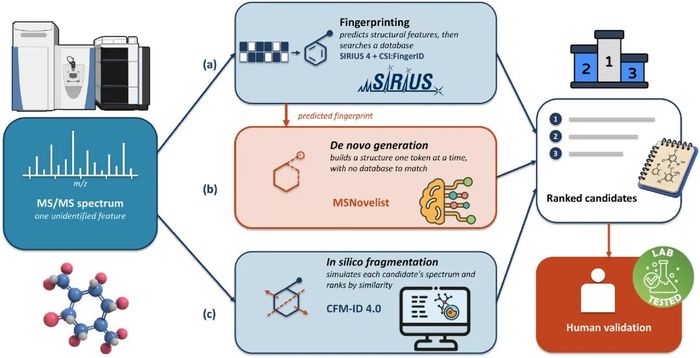
图2 三类机器学习注释方法互补覆盖非靶向注释缺口,de novo以预测指纹为输入,并非第三条平行路线
高分辨质谱(high-resolution mass spectrometry, HRMS)每个样品产生数千个特征,库匹配只能确证少数,其余约90%(液相色谱-质谱非靶向代谢组学的典型数字)需推定注释。(a)指纹预测从MS/MS谱图预测结构特征向量,再检索结构数据库完成指认,SIRIUS 4与CSI:FingerID取得76% top-1与91% top-5的分子式指认召回;(b)de novo直接从谱图构建结构,MSNovelist在3863个GNPS化合物上top-1为25%、top-128为45%,同一集合上指纹预测为39%;(c)计算机模拟碎片化从候选结构正向模拟谱图,CFM-ID 4.0的dot-product得分较早期版本在正、负离子模式分别提升26.7%与20.6%。值得注意的是,这些数字来自经筛选的基准集,化合物常取自训练所用的数据库,换仪器或碰撞能量方案后准确率会回落;三类方法都会给出貌似合理却错误的候选,人工验证仍是不可省略的一步。
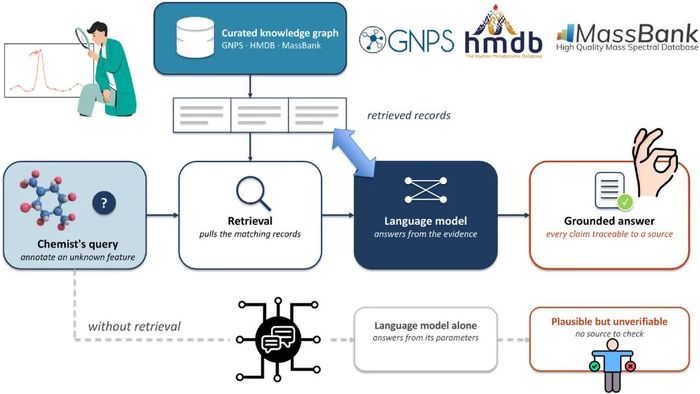
图3 检索增强生成让每个陈述都能溯源到知识图谱,没有检索的答案同样流畅却无从核对
组件有三层:建在GNPS、HMDB与MassBank等精选资源之上的知识图谱,按语义相似度取回相关子图的检索层,以及基于检索证据作答的生成层,即检索增强生成(retrieval-augmented generation, RAG)。这一组合显式降低了纯LLM方案的幻觉,是输出可追溯、走向实验室专属助手的最实用路径,评述建议把它建在自有仪器数据与精选文献之上。
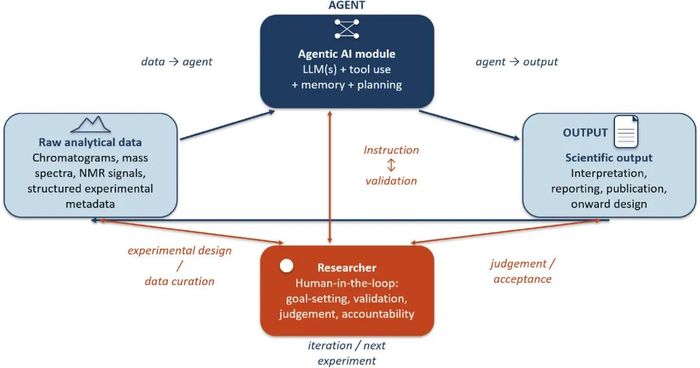
图4 人在回路架构中研究者与全部三个节点双向相连,图示表达的是权威所在,而非工作发生的位置
架构有三个节点与四条边:原始分析数据、带工具使用记忆与规划能力的代理、可解释的科学结果;化学家定义目标、监督轨迹、验收输出,并因实验由其设计而连回输入端。人是承重构件而非让步:ChemBench的2700多道题上最好的模型整体超过人类专家平均水平,却在包括分析化学在内的题目上表现最差,预测核磁共振(NMR)信号数的题正确率仅22%,且模型对自身答案的置信度标定很差,失败不会主动暴露。
一、AI进入分析化学实验室,应该从哪里开始?
作者认为,分析化学实验室应用AI,关键不在于追求更高的自主化程度,而在于让AI真正融入现有科研流程。 文章将AI系统划分为四个层级,从辅助文献阅读、代码编写的单一大语言模型,到能够调用专业工具、协调多项任务的AI Agent,再到自主运行的机器人实验室。对于大多数分析化学实验室,作者更倾向于从具备检索、计算和代码执行能力的工具增强型AI入手,而不是直接追求复杂的多代理系统或实验室全面自动化。
“人在回路”(Human-in-the-loop)是贯穿全文的核心主张。 AI可以承担文献检索、数据处理、代码编写和部分分析任务,但研究人员仍需负责研究设计、过程监督和结果验证。尤其在质谱结构解析、非靶向筛查等高度依赖专业判断的工作中,AI生成的候选结果不能直接等同于可靠的化学鉴定。作者强调,AI应用的目标不是让化学家退出科研流程,而是减少重复性工作,使其能够将更多精力投入科学判断与结果验证。
二、这些基准数字对自家实验室的参考价值有多大?
方向可参考,数字不宜直接搬用。 其一,性能值来自仍在快速迭代的基准,模型版本可能数月内被替代,数字比定性结论过期更快;其二,基准化合物常取自训练所用的库,真实样品与跨仪器条件下性能普遍低于发表值,跨实验室验证比排行榜名次更重要;其三,表2各系统在不同任务与条件下评测,多实验室共享谱图与预定数据划分的标准化基准被列为2至4年尺度的机会。但要得到适用于自己工作流的数字,只能在自有数据与自建基准上重测,这正是评述把组级RAG管线列为第一条建议的原因。
三、AI辅助写作、审稿与数据处理的边界在哪里?
作者主张,对AI辅助写作应优先采用透明披露,而不是简单依赖AI文本检测。使用AI润色、生成代码或整理材料,并不免除研究人员核对数据、引文和结论的责任;未经授权,也不应把保密稿件或受限制的实验数据输入外部服务。论文进一步提醒,生成式AI可能伪造色谱图、质谱图等研究数据,因此原始数据、处理记录及结果可追溯性比判断一段文字“是不是AI写的”更重要。实际使用仍须遵守目标期刊、机构和资助方的具体规定。
分析与健康前沿
展源
何发
热点文章
-
安捷伦洞察检测需求,共建高效实验室市场调研
2026-09-01
-
快讯!赛默飞任命Dan Rosen为中国区总裁
2026-08-18
-
2026 国自然集中接收项目评审结果放榜,多项资助规模上调
2026-08-26
-
哈工大谭久彬院士团队合作发明化学反应发光超分辨成像新方法
2026-08-14
-
【必看】怎么看XRD图!
2026-08-18
-
2026年诺贝尔化学奖揭晓:法日科学家发现不对称有机合成自催化与非线性效应
2026-10-07
-
北京公开征集自主实验室储备课题,覆盖多领域表征测试研究
2026-08-12
评论
加载更多